Hay situaciones en TI que parecen ponerse de acuerdo para ocurrir al mismo tiempo. Hace poco me tocó ver una aplicación web que funcionaba sin problemas sobre un Windows Server con IIS. Todo estaba concentrado en un solo servidor y, hasta ese momento, había cumplido perfectamente con su trabajo. El problema llegó cuando un despliegue quedó incompleto justo cuando Windows tenía programada una actualización.
¿El resultado? Pantallazo azul, servidor fuera de servicio y una aplicación que dejó de estar disponible, y entonces comienza una escena bastante conocida: desarrollo revisa el código, el DBA confirma que la base de datos está funcionando e infraestructura intenta descubrir qué ocurrió con el servidor.
Más allá de encontrar al culpable, que pocas veces ayuda, este tipo de incidentes nos deja una pregunta mucho más interesante: ¿qué podemos hacer para que la próxima vez que falle un servidor la aplicación no se vaya con él? Ahí es donde tenemos que hablar de Alta Disponibilidad en Azure y, particularmente, de servicios como Azure Traffic Manager.
Alta Disponibilidad y Disaster Recovery: parecidos, pero no iguales
Cuando diseñamos una aplicación que necesita permanecer disponible, hay dos conceptos que aparecen constantemente: High Availability (HA) y Disaster Recovery (DR). La Alta Disponibilidad busca reducir al máximo las interrupciones del servicio. En lugar de depender de una sola instancia, diseñamos la solución con redundancia para que pueda continuar operando aunque alguno de sus componentes presente problemas.
Disaster Recovery tiene otro objetivo: estar preparados para recuperar la operación cuando ocurre un incidente mayor y necesitamos utilizar otra infraestructura, réplica o región. Podemos resumirlo así: HA intenta mantenernos operando; DR nos prepara para recuperarnos.
Y aquí aparece una idea que considero fundamental al diseñar sistemas: no deberíamos construir pensando que un servidor nunca va a fallar. Debemos construir pensando qué va a pasar cuando falle. Porque tarde o temprano algo va a fallar, eso es un hecho.
Antes del balanceador está la arquitectura de tu aplicación
Supongamos que decidimos solucionar el problema colocando dos servidores con exactamente la misma aplicación.
Perfecto. Ya tenemos redundancia, pero ahora aparece otro problema. Imaginemos que el usuario inicia sesión en el servidor A y nosotros almacenamos toda la información de su sesión en la memoria de ese servidor. En su siguiente petición, el balanceador decide enviarlo al servidor B, y justamente el servidor B no conoce esa sesión, y nuestro usuario probablemente tampoco estará muy contento.
Por eso, una de las primeras recomendaciones al diseñar aplicaciones para escenarios de alta disponibilidad es evitar que el estado importante dependa de una instancia específica. Es lo que normalmente conocemos como una arquitectura stateless.
Quienes hemos trabajado con ASP.NET, Razor o incluso PHP seguramente hemos utilizado variables de sesión para resolver rápidamente este tipo de necesidades. No significa que utilizar sesiones sea automáticamente incorrecto; significa que debemos pensar dónde vive ese estado cuando nuestra aplicación comienza a distribuirse entre diferentes servidores.
La arquitectura de alta disponibilidad no empieza cuando agregamos el balanceador. Empieza desde cómo desarrollamos la aplicación.
Entonces, ¿qué balanceador necesito en Azure?
Aquí es donde Azure puede confundirnos un poco al principio. Tenemos Traffic Manager, Front Door, Application Gateway, Load Balancer… y cuando uno empieza a estudiar estos servicios es bastante normal preguntarse: “Muy bien, ¿pero cuál uso?”
La decisión se vuelve más sencilla si primero identificamos qué tipo de tráfico estamos manejando y si nuestra solución necesita operar regional o globalmente.
| Servicio | Alcance | ¿Para qué lo utilizaría? |
|---|---|---|
| Azure Traffic Manager | Global | Distribución y failover mediante DNS |
| Azure Front Door | Global | Aplicaciones HTTP/HTTPS, aceleración, WAF y distribución global |
| Application Gateway | Regional | Routing y balanceo de aplicaciones web dentro de una región |
| Azure Load Balancer | Regional / global | Tráfico TCP/UDP en capa 4 |
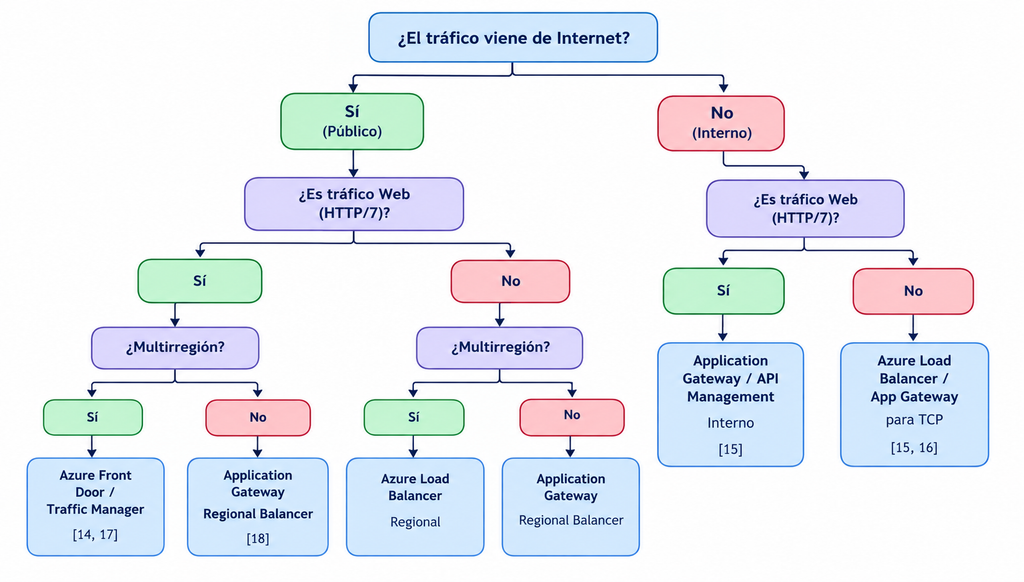
Por ejemplo, si necesitamos balancear conexiones TCP entre servidores dentro de nuestra infraestructura, Azure Load Balancer puede ser una alternativa. Si hablamos de una aplicación web regional donde necesitamos routing HTTP/HTTPS, podemos entrar en el terreno de Application Gateway.
Si queremos una entrada global para una aplicación web, con WAF, aceleración y capacidades de entrega de contenido, Azure Front Door cobra mucho sentido. Pero si lo que necesitamos es tomar decisiones globales a nivel DNS entre diferentes endpoints, entonces aparece Azure Traffic Manager.
¿Qué hace realmente Azure Traffic Manager?
Traffic Manager tiene una característica muy importante: no recibe y retransmite el tráfico de nuestra aplicación como lo haría un proxy tradicional, trabaja a nivel DNS. Cuando un usuario intenta acceder a nuestro dominio, Traffic Manager evalúa los endpoints disponibles y, según el método de routing que hayamos configurado, responde indicando a qué endpoint debe conectarse.
Podemos utilizar Priority cuando queremos tener una región principal y otra como respaldo; Weighted cuando queremos repartir determinadas proporciones de tráfico; o Performance cuando tenemos infraestructura en diferentes ubicaciones y buscamos utilizar el endpoint con menor latencia de red para el usuario. Y aquí encontramos otra ventaja interesante: Traffic Manager puede trabajar con endpoints externos a Azure.
Eso abre la puerta a arquitecturas híbridas o multinube donde, por ejemplo, una parte de nuestra solución esté en Azure y otra en otro proveedor. Traffic Manager no necesita que todo viva obligatoriamente dentro del mismo ecosistema.
De México a España: Traffic Manager en acción
Para llevar todo esto a un escenario práctico, durante la sesión de Un Show para TI hice una prueba con dos Azure App Services ejecutando la misma aplicación en Blazor.
Una instancia estaba desplegada en México Central y la segunda en España Central. Ambas estaban asociadas a un perfil de Azure Traffic Manager y a un mismo dominio mediante la configuración DNS correspondiente.
La idea era sencilla: tener dos ubicaciones capaces de entregar la aplicación y comprobar qué sucedía cuando una dejaba de estar disponible.
Traffic Manager realiza verificaciones de salud sobre los endpoints. Si configuramos un escenario donde México es nuestro endpoint principal y este deja de responder correctamente, el servicio puede dejar de devolverlo como destino y utilizar un endpoint saludable alternativo.
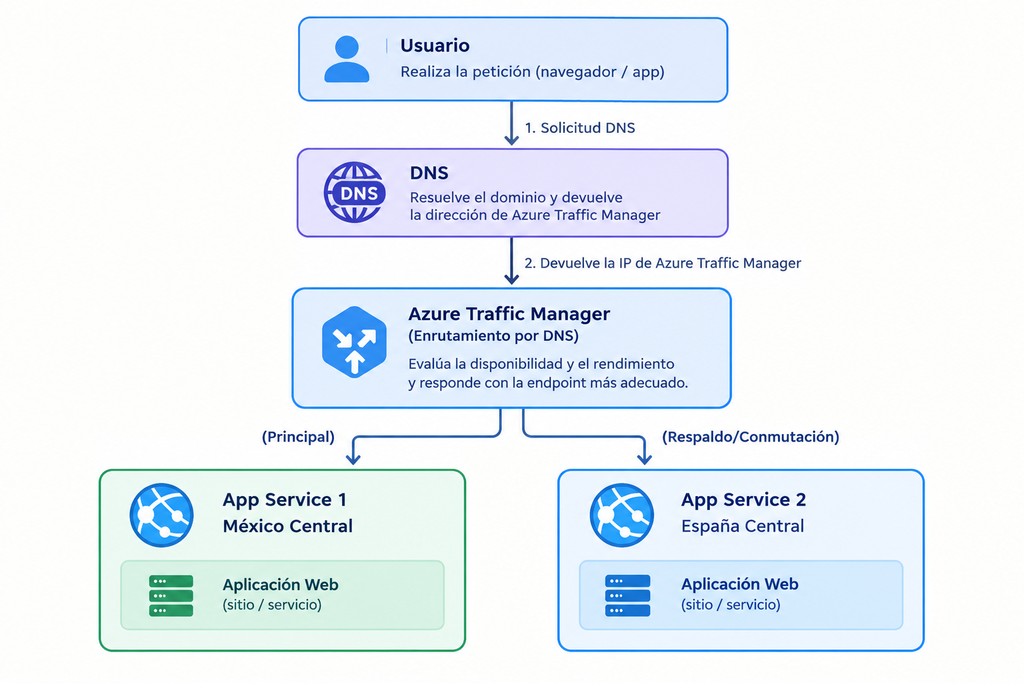
Durante la demostración detuve intencionalmente el App Service de México para comprobar el comportamiento. Y como todo buen demo en vivo… al principio no funcionó. 😅
El DNS seguía resolviendo de una manera que no esperaba hasta que apareció el verdadero culpable: tenía una VPN activa en mi equipo. Al desconectarla y volver a comprobar la resolución, el tráfico terminó llegando correctamente a la aplicación desplegada en España.
Más allá de la anécdota, el ejemplo también demuestra algo importante sobre Traffic Manager: DNS importa.
Los cambios no deben entenderse como una conmutación instantánea de todas las conexiones existentes. Los resolvers y clientes pueden mantener respuestas DNS en caché durante el tiempo definido por el TTL. Por eso la configuración del monitoreo, los health probes y el TTL forman parte de una buena estrategia de failover.
Alta disponibilidad no significa simplemente duplicar servidores
Podríamos terminar aquí pensando que dos App Services y Traffic Manager resuelven todo, pero sería quedarnos a la mitad.
¿Qué ocurre si tenemos una aplicación en México y otra en España, pero ambas dependen de una única base de datos que solamente existe en México?
Seguimos teniendo un punto único de fallo. Lo mismo puede ocurrir con almacenamiento, APIs, servicios de autenticación, caché o cualquier otra dependencia crítica.
Por eso, cuando un cliente nos dice que necesita una aplicación que “nunca se caiga”, la conversación no debería empezar únicamente por qué servicio de Azure vamos a contratar. Primero debemos entender qué nivel de disponibilidad necesita realmente el negocio y qué componentes forman parte de la solución.
Después podemos diseñar la arquitectura adecuada.
Diseñar para el fallo cambia nuestra forma de construir software
La nube nos ofrece herramientas impresionantes, pero Azure Traffic Manager, Front Door o cualquier balanceador no pueden corregir por sí solos una arquitectura que depende completamente de un único componente.
La verdadera Alta Disponibilidad aparece cuando pensamos en redundancia desde el diseño de la aplicación hasta la infraestructura que la soporta.
Mi recomendación es cambiar ligeramente la pregunta. En lugar de preguntar “¿cómo hago para que mi servidor nunca falle?”, preguntémonos: “Si este componente falla mañana, ¿qué sucede con mis usuarios?”
Si la respuesta es “nadie puede utilizar la aplicación”, acabamos de encontrar un punto que vale la pena revisar. Porque al final, diseñar Alta Disponibilidad no consiste en evitar todos los fallos. Eso sería una batalla bastante complicada.
Consiste en conseguir que un fallo no tenga que convertirse necesariamente en una caída del servicio.
Y ahí es donde empieza una buena arquitectura.